高级图像生成
本指南默认你已经读过基础篇,不再重复。
往下读之前最该知道的一件事:Soulkyn 同时跑着两个系列的图像模型,而下面几乎所有内容只适用于其中一个。SD 系列(SD - Anime Original、SD - Anime Alpha、SD - Anime Hyper)基于 Stable Diffusion——吃标签式提示词,开放权重、采样器、CFG 与 CLIP skip。自然语言系列(SK-Alpha、ZIT - Sk-All、ZIT - Sk-Photo、ZIT - Sk-Real)吃普通句子,用一个 Force Style 开关取代了上面大部分控件。
所以本页先从自然语言系列讲起,再深入 SD 控制面板、权重、风格化、预设与提示词结构,最后收在 AI 图像编辑。
自然语言模型:SK-Alpha 与 ZIT
七个模型里有四个——SK-Alpha、ZIT - Sk-All、ZIT - Sk-Photo 与 ZIT - Sk-Real——根本不要标签。写一句话,就像你对一个马上要动笔画它的人描述这幅画。
有什么不同
- 没有权重语法。
+、-和:2在这里不是语言。强调来自你选择说什么、以及句子怎么排列,跟平常写字一样。 - 没有 CFG、没有 CLIP skip、没有采样器。那整块面板属于 SD 系列。不是缺了什么,而是这些旋钮压根没有对应物。
- 取而代之的是 Force Style。一个 Realistic / Anime 子开关,无论提示词怎么写都把渲染风格钉死。当模型总往错误的风格上飘时,就该伸手去按它——比在句子里跟它讲道理可靠得多。
- 空间更大。提示词 1,400 字符而非 550,LoRA 最多 4 个而非 3 个。
- 人脸参考在两个自然语言系列上都可用,这是让同一个角色在一整组图里保持辨识度的实用办法。
怎么挑
SK-Alpha 是写实类的专才,只在写实系 kyn 上出现,纯动漫 kyn 上会被隐藏。它没有 img2img。ZIT - Sk-All 是宽口径的通才,ZIT - Sk-Photo 偏摄影,ZIT - Sk-Real 偏写实,三者都支持 img2img:把一个 Soulkyn 图片链接粘进去作底图,模型就从那儿开始。
怎么写得好
- 描述画面,而不是罗列名词。主体在哪、在做什么、镜头在哪、光在做什么。
- 一句清楚的话胜过五句自相矛盾的从句。结果混乱的时候,提示词通常也是。
- 每次只改一处。整句重写,你就不知道是什么动了结果。
- 用 Force Style 定风格,别用一堆形容词去跟模型的默认值较劲。
从这里到“常见问题”结尾,讲的都是 SD 系列。权重、采样器、CLIP skip 与 CFG 在 SK-Alpha 和 ZIT 系列上并不存在——在那些模型上,用一句话描述你想要的,然后用 Force Style。顺带更正一点:下文提到的 CFG 区间属于通用理论,而 Soulkyn 的提示词强度滑块范围是 5.5 到 11,默认 7.5。把那些区间当作相对参考,而不是你会看到的实际刻度。
高级设置

层
层是构成图像模型的"块"。将Stable Diffusion想象成一座由楼层组成的塔 - 每个"块"都有自己的工作:
- 早期层 - 捕获低级细节(边缘、颜色、纹理)
- 中间层 - 捕获图案和形状(面部、服装、身体结构)
- 后期层 - 捕获语义含义(如"猫"与"狗"或"动漫风格"与"照片"的概念)
LoRA
LoRA是用于微调大型模型的训练方法。当您有图像模型时,LoRA通过将自己注入某些层来教它新技巧 - 就像重塑塔中的特定楼层。
CLIP跳过层
Stable Diffusion使用CLIP(对比语言-图像预训练)作为文本编码器,将您的提示词转换为嵌入。CLIP基本上是您和图像模型之间的翻译器。跳过层会切断更高级别的理解。
许多动漫模型和LoRA在训练时考虑了CLIP跳过值(最常见的是2)。跳过一层可能会给您更像动漫或风格化的结果。
调度器
调度器控制生成过程中的去噪过程。它强烈影响图像的清晰度、连贯性和提示词遵循度。
Euler a - 快速
- 产生清晰、细节丰富、对比度强的图像
- 非常适合动漫、风格化艺术或素描般的细节
- 有时在写实方面不稳定 - 可能会扭曲精细纹理或面部
- 何时使用: 快速、创意、详细的动漫风格或概念艺术输出
DPM++ SDE Karras
- 产生平滑、高质量的渐变和柔和的过渡
- 非常适合较小的细节
- 每次渲染都会有所不同 - 适合有机变化
- 何时使用: 照片级真实渲染、自然光照、绘画风格、柔和过渡
DPM++ 2M - 确定性
- 产生平滑、一致的结果,具有高提示词保真度
- 速度和准确性之间的良好平衡
- 何时使用: 写实主义、肖像、稳定性重要的一致风格
DPM++ 2M Karras
- 产生比普通DPM++ 2M更平滑的渐变、更好的纹理和更高的细节保真度
- 比Euler A稍慢,但写实质量更高
- 何时使用: 照片级真实图像、肖像、复杂纹理 - 最适合精致、稳定的外观
提示词强度
提示词强度改变CFG比例 - 值越高,系统越遵循您的图像提示词。
- 低CFG (1-5): 模型较少关注提示词。更多艺术自由,更梦幻的构图。风险:图像偏离您的要求。
- 中等CFG (6-9): 遵循度与创造力之间的平衡。常见最佳值:7-8。保持准确性和美观性。
- 高CFG (10+): 强烈遵循关键词。可能变得过饱和、刺眼或"烧焦"。风险:奇怪的伪影、僵硬或不自然的图像。
权重
+的实际权重是1.1^x(其中x = +的数量)。而-是0.9^x。
| 符号数量 | -的权重 | +的权重 |
|---|---|---|
| 1 | 0.9 | 1.1 |
| 2 | 0.81 | 1.21 |
| 3 | 0.729 | 1.331 |
| 4 | 0.6561 | 1.4641 |
| 5 | 0.59049 | 1.61051 |
| 6 | 0.531441 | 1.771561 |
免责声明:此表不是数学表!它是最终结果的视觉表示!
您可以利用系统:(keyword-)2等同于(keyword)1.8。更复杂的:(keyword---)2计算为(keyword 0.9^3)2 = 0.729 * 2 = (keyword)1.458
风格化
关键词和权重的组合可以实现某些所需的外观。使用painterly_shading的示例:
| 使用Painterly_shading+++ | 不使用 |
|---|---|
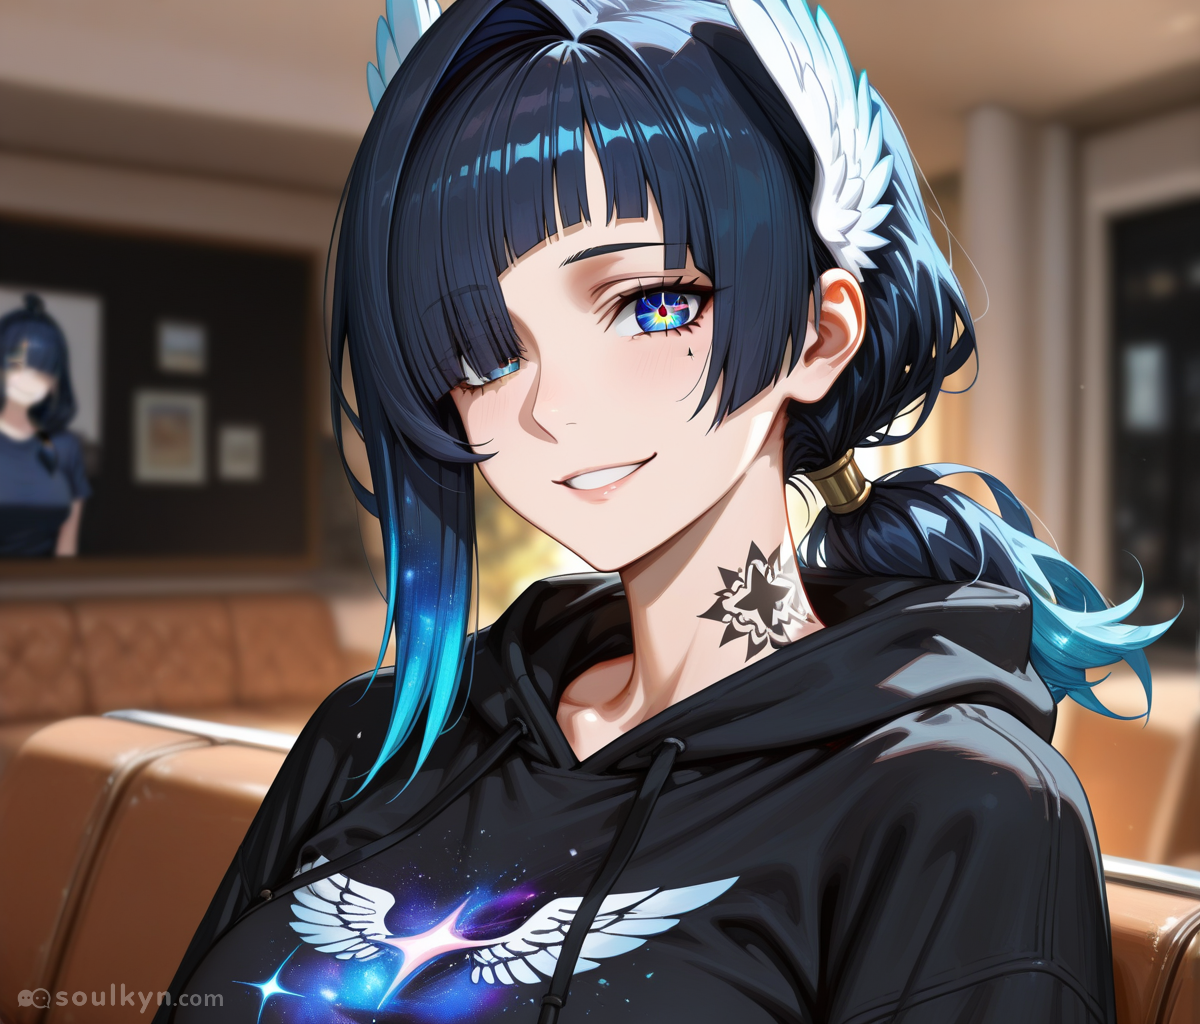 | |
您可以改变:
- 风格/风格化 - 整体外观
- 阴影/光照 - 体积和深度
- 线稿 - 边缘的定义
- 比例 - 主题的描绘方式
- 纹理/细节 - 表面细节
- 构图/取景 - 排列
- 模拟 - 图片模拟的媒介
- 质量 - 整体质量
预设和物理
在 SD 模型上,图像提示词上限是 550 字符——一旦写上质量标签、姿势、机位和氛围,这个额度就很紧了。预设正是绕开它的办法:背景、服装与提示词预设自带标签,不占用你那 550 个字符。
真实的上限
- 服装预设:最多 18 个标签,每个标签 38 字符。
- 背景与提示词预设:最多 35 个标签,每个标签 50 字符。
- 图像提示词本身:SD 模型 550 字符,自然语言模型 1,400 字符——而在后者上,这种预设塞法本来就不需要。
压缩技巧
- 用分号
;把几个相近的含义塞进同一个标签。 - 用下划线
_把词粘成一个整体,让模型当作一个概念来读。 - 用
:2加重权重——它是归一化的,不会把画面炸掉。
实例:PaintFuka 风格的角色
Physical tags: Painterly; Soft; No_lineart, 8K;16K; Hdr, Blue Lips, Slim Eyebrows; Fair_skin:2, Long Two-Toned Dark_blue Hair, Realistic_character_anatomy, High Quality, Highest_quality; Extremely_detailed, Adult_woman:2; Mature_woman:2, Realistic Details, Painterly Texture, Cute;Kawaii, Digital_painting:2, Thick Thighs; Slim Waist, High Contrast, Painterly Details, Long Blue Hair; Blue Eyes, Dramatic; Epic; Emotional
Clothing tags: Hyperdetailed_eyelashes, High_contrast:2; Shadows:2; Light:2, Realistic:2; Anime:2, Canvas_tone_texture; Hyperdetailed, Hyperdetailed_skin:2, Expressive;Hyperrealistic:2, Hyperdetailed_body:2; Cute:2, Glow_diffusion; Saturated_colors:2, Hyperdetailed_shading, Hyperdetailed_textures:2, Hyperdetailed_hair, Glowing_eyes:2; Big_eyes:2, Hyperdetailed_clothing:2, Hyperdetailed_eyes:2, Art Bloom; Soft; Hard; Hairstrands, Painterly_skin_softness; Kawaii:2;, Soft Light; Thick Thighs; Matte_skin:2, Realistic Anime; Soft Shading
Background: Glowing Highlights, Detailed Rendering, Vibrant Colors, Saturated Colors, Ambient Lighting, Anime Art Style, Cell Shading, Rim Lighting, Digital Painting, Semi-Realistic, Soft Shading, Smooth Gradients, Dramatic Lighting, Polished Finish, Professional Artwork, Clean Lineart, High Contrast, Artstation Quality; Highest Quality
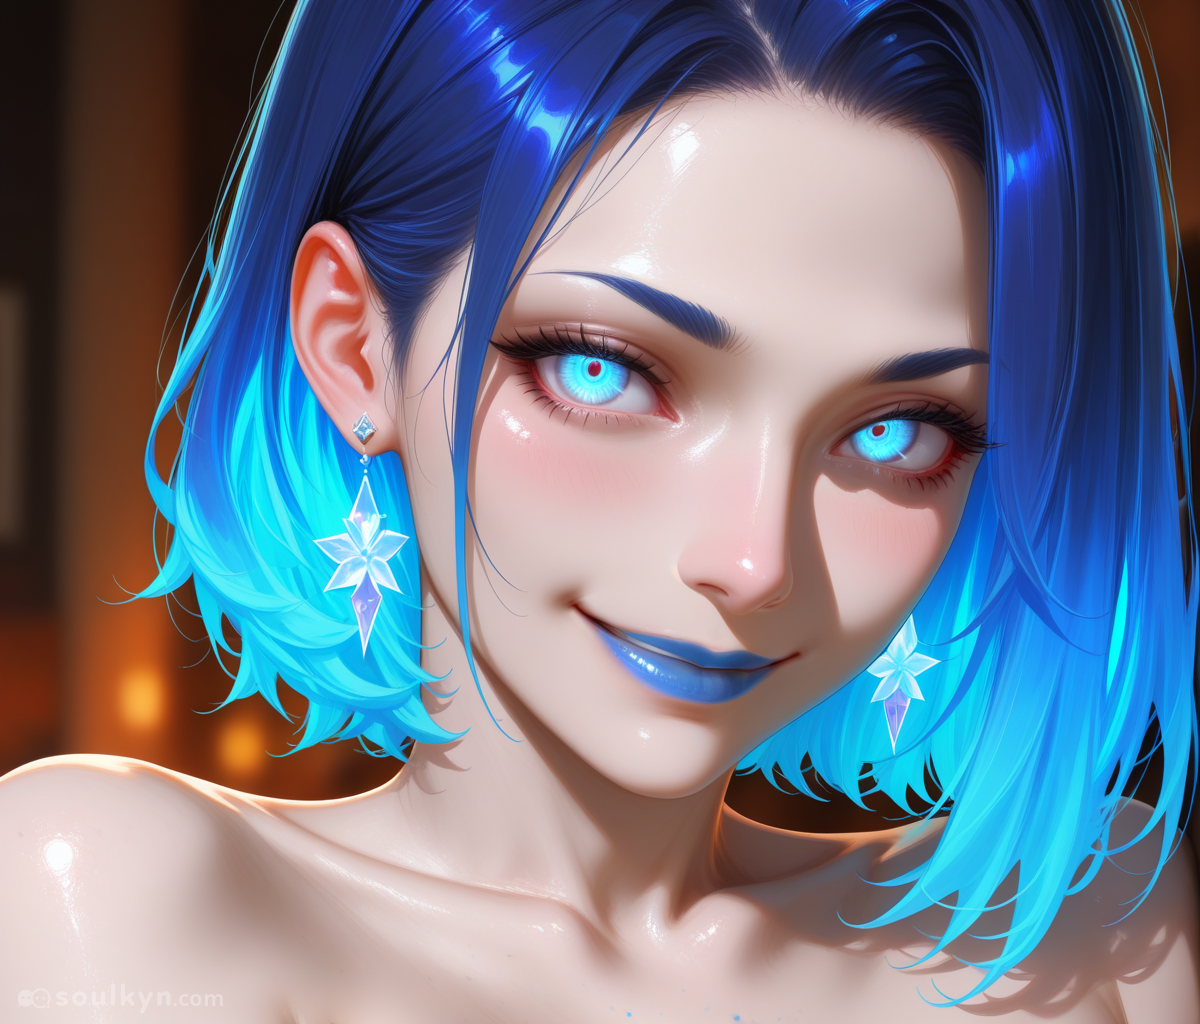
拆读其中一部分外貌标签:
- Painterly — 更多绘画质感的细节
- Soft — 画面更柔和
- No_lineart — 不要线稿(作用类似负面词)
- 8k; 16k / High Quality — 要求非常高的质量
- Hdr — 明暗对比更深
- Blue lips — 角色是蓝唇
- Fair_skin:2 — 白皙肤色是认真的
- Long Two-Toned Dark_blue Hair — 两种蓝色调的长发
- Realistic_character_anatomy — 写实的人体结构
高级提示的结构
是时候运用我们所有的新知识来更有创意地制作提示词了!为此,我们将使用PaintFuka的背景和服装。
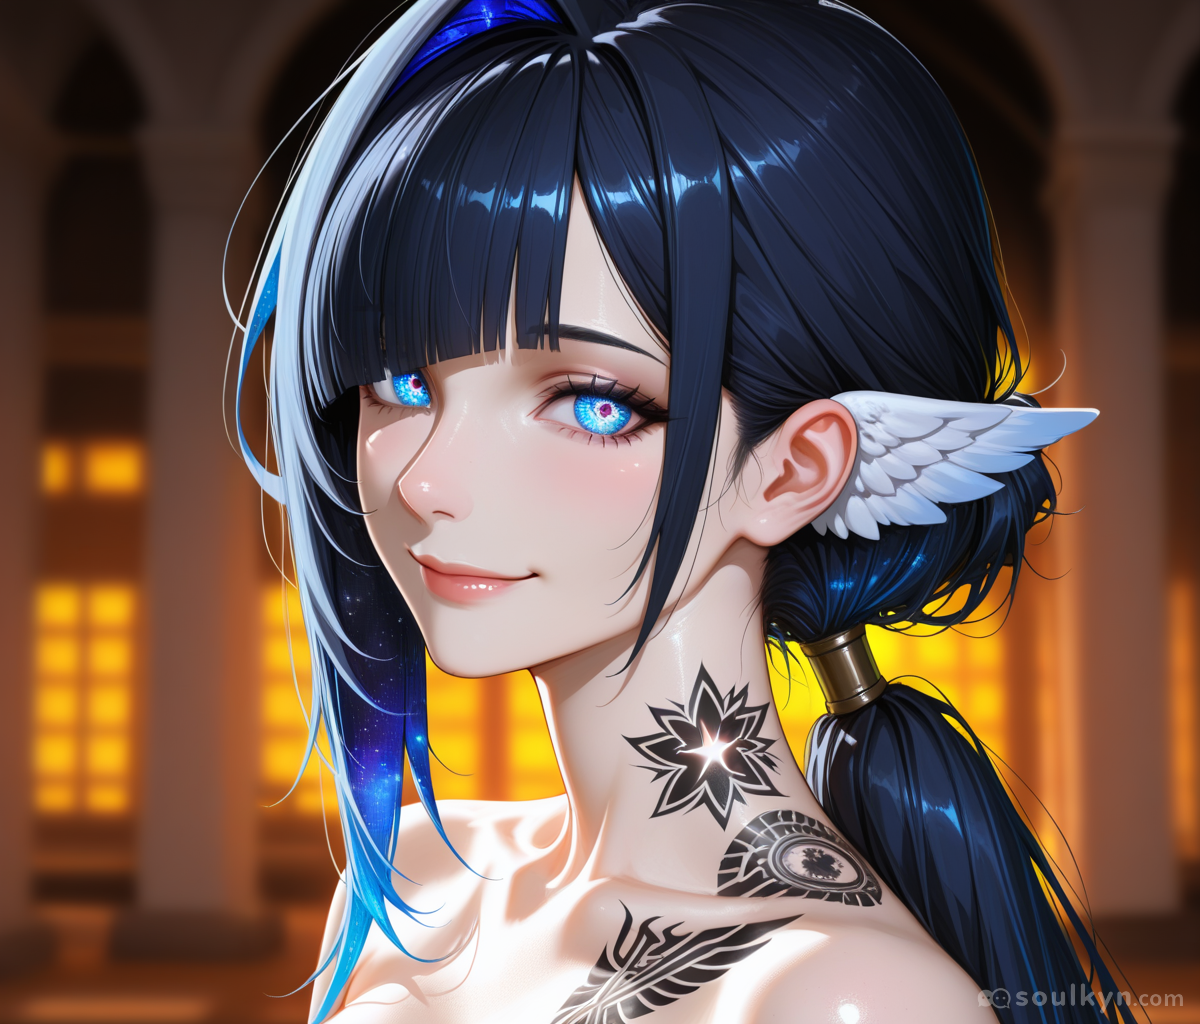
这是未风格化提示词和风格化提示词之间的比较:
| 未风格化 | 风格化 |
|---|---|
|  |
首先让我们描述一下我们想要创建的图片:
- 人数:1
- 视角:牛仔镜头(膝盖以上视角)
- 角色穿着白色夏季连衣裙
- 角色在跑步时伸出一只手
- 表情:微笑
- 背景:不重要,可以模糊以突出角色
- 质量:极其详细的真实插图
考虑到这个列表,让我们准备所有的LoRA、调度器和关键词。
因为我们希望图片类似于详细的真实插图,所以让我们使用专门用于此目的的LoRA!
这是应用微观/精细细节:6和真实插图:6 LoRA的结果:
| 使用LoRA | 不使用LoRA |
|---|---|
 | |
现在让我们给她穿上衣服并让她跑起来!
最终提示词:
高级设置:
- LoRA: Micro / Fine details :6, Realistic Illustration :6
- 提示词强度: 11.0
- CLIP跳过: 2
- 调度器: DPM++ 2M
- 图像方向: 横向
- 种子: 随机
- 提示: Portrait
- 背景: PaintFuka
- 服装: PaintFuka
- 图像提示词:
(solo, alone)+++, (macro_detail, clean_composition, color_balance, 8k_realistic_render, professional_product_shot)+++, (close, cowboy_shot)++++, (white_summer_dress---)2, (running)+++, (reaching_out, one_hand, outstretched_hand)+++, (smiling, Happy, open_mouth, closed_eyes)+, (blurry_background--)2
最终结果:
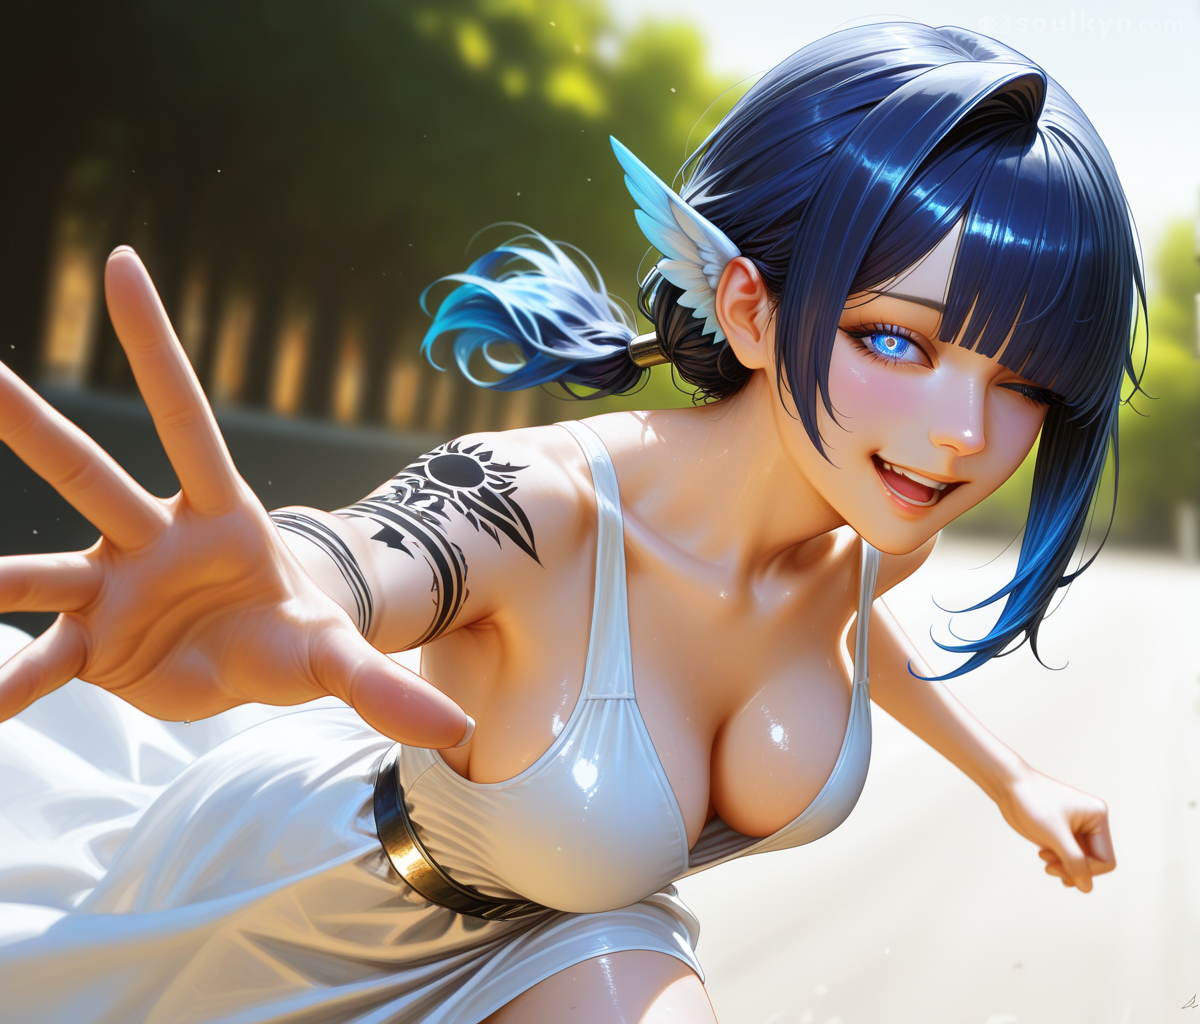
现在让我们分析提示词中包含的内容以及它是如何工作的:
(solo, alone)+++- 使角色独自出现在图片中(macro_detail, clean_composition, color_balance, 8k_realistic_render, professional_product_shot)+++- 这些告诉AI我们想要获得的图片质量(close, cowboy_shot)++++- 这告诉AI我们想要一个非常近的牛仔镜头(white_summer_dress---)2- 这强制AI给我们的角色穿上白色夏季连衣裙(running)+++- 这告诉AI我们想要角色在跑步(reaching_out, one_hand, outstretched_hand)+++- 这精确地告诉AI我们想要什么样的姿势(smiling, Happy, open_mouth, closed_eyes)+- 这定义了我们角色的表情(blurry_background--)2- 这强制AI给我们一个模糊的背景
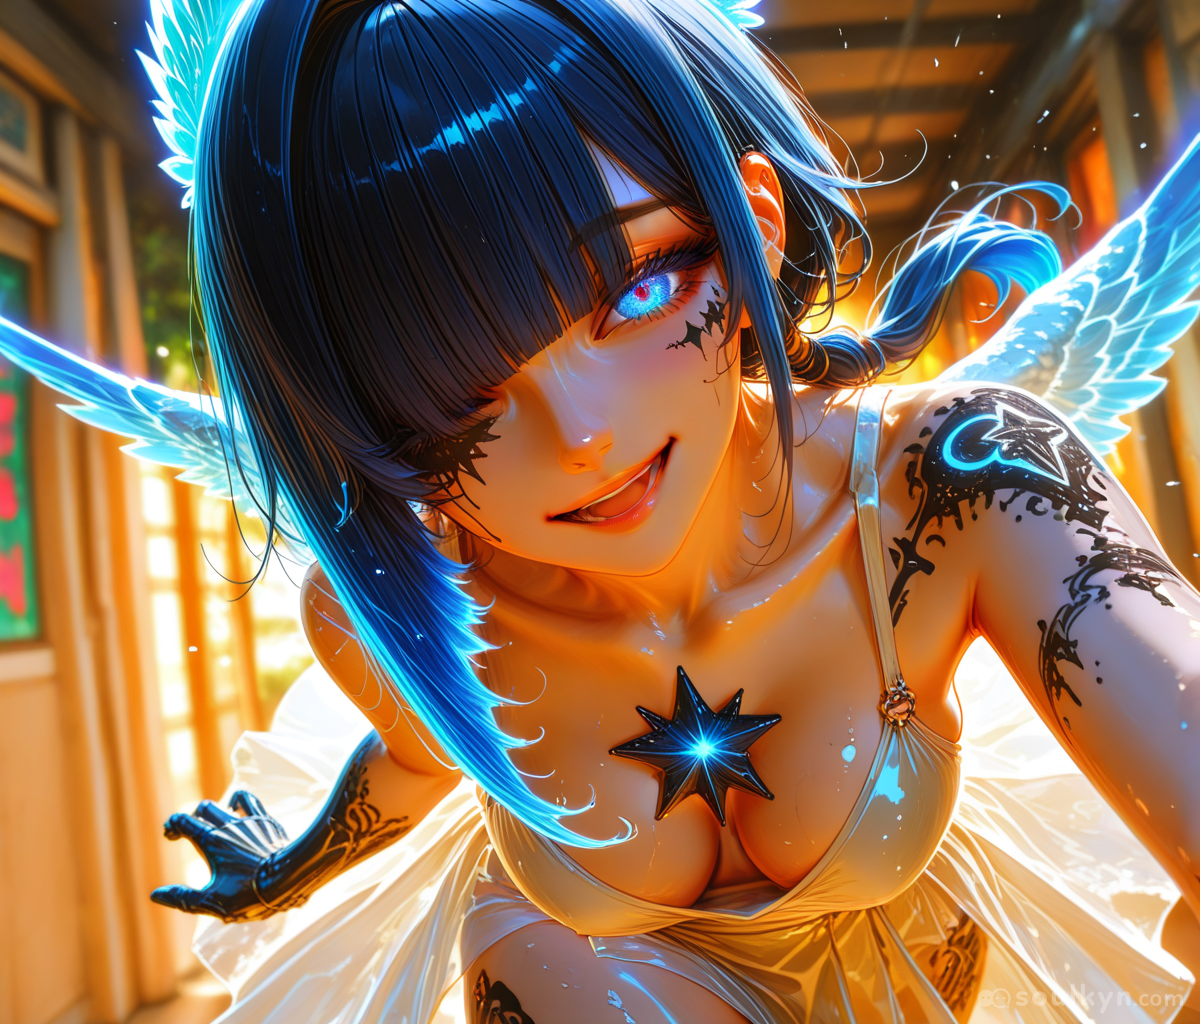
作为额外内容,这是仅添加一个LoRA的效果:
常见问题
最常见的问题是质量下降 - 一些用户称之为"地毯化",因为损坏的图像看起来像地毯表面的特写。
这很可能是由于:
- 权重过多
- LoRA强度过大
- 标签冲突
AI 图像编辑
编辑已有图像是一个独立于生成的工具,也是整个平台上唯一一处:无论那张图由哪个模型画出,你都用普通句子跟模型说话。
入口在哪
- 打开某个 kyn 的画廊
- 选中你想改的那张图
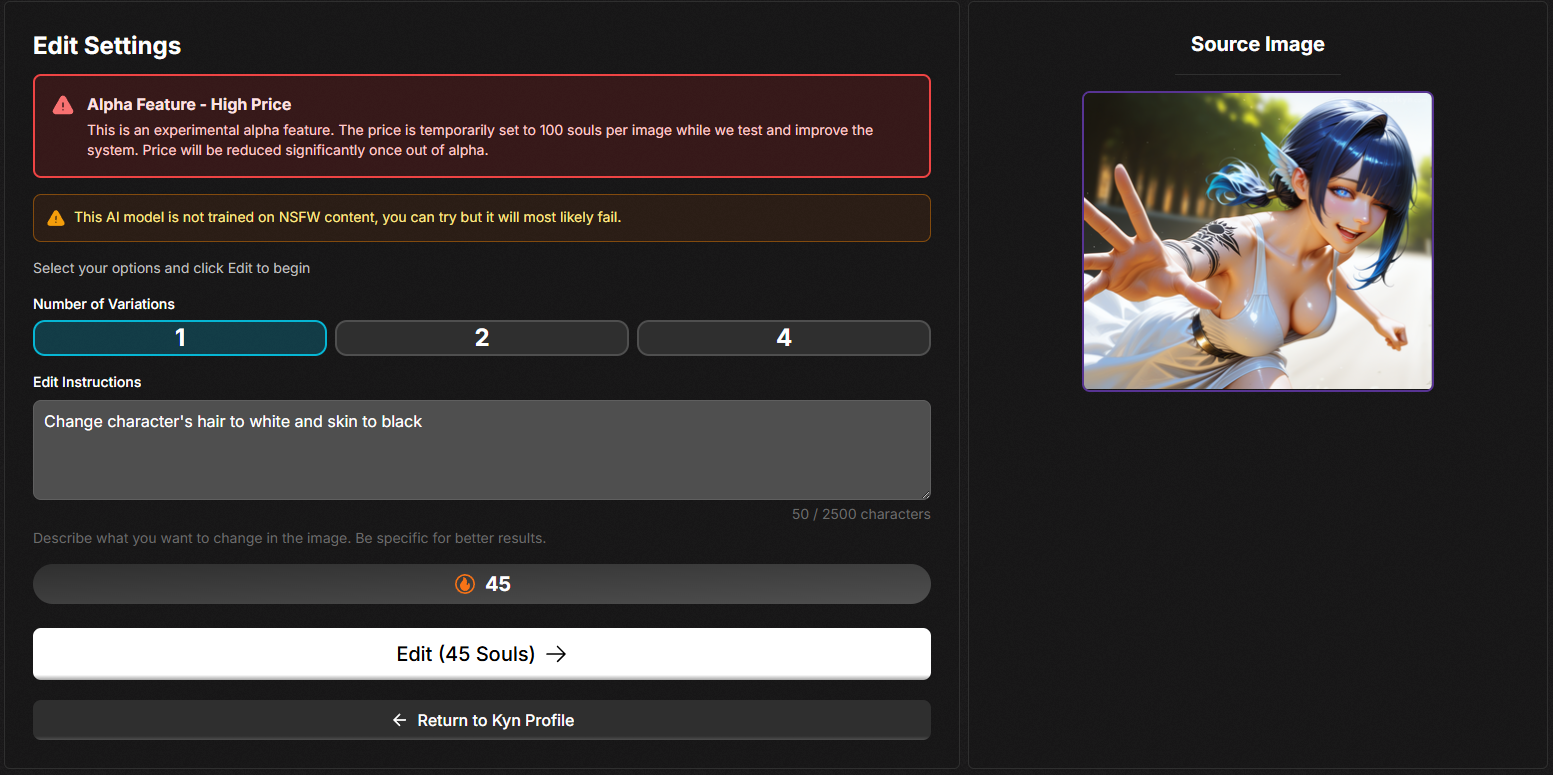
- 按 EDIT IMAGE
指令怎么写
写描述性的句子,不要写标签。说清楚哪里要变:“把角色的头发改成白色,肤色调深一些。”指令上限 2,500 字符,另有 Number of Variations 控件,可以一次尝试多个结果。
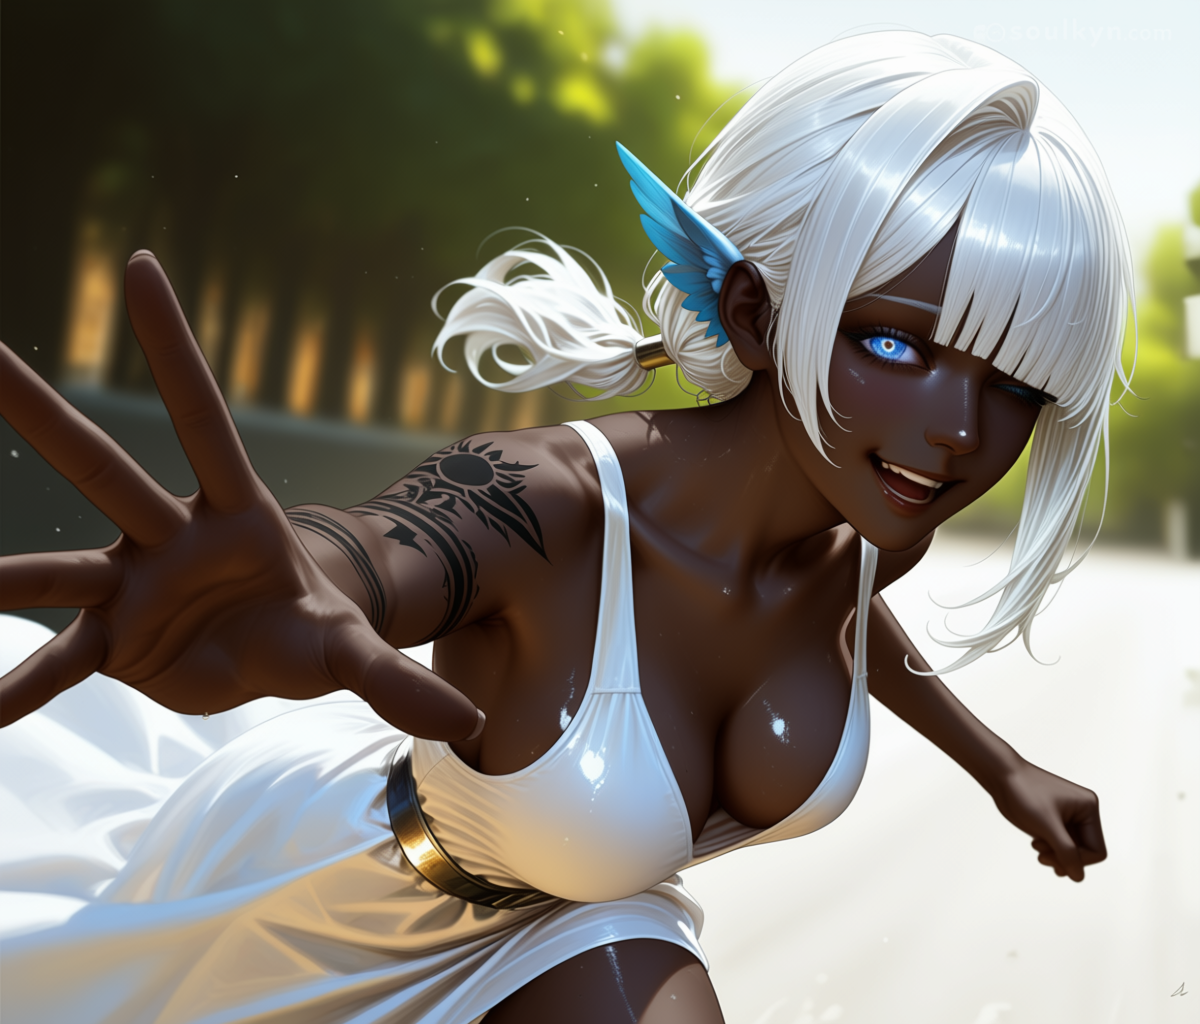
风格预设
在普通编辑之上,还有十三种风格增强:None (Standard Edit)、Caricature、Next Scene、Photo to Anime、Balloon Inflate、Object Remover、Object Adder、Polaroid Photo、Camera Angle Change、Futanarify、To Realistic Photo、Upscale Quality 与 18+ Mode。
动手前要知道的两件事
- 结果会先挂起等你确认。生成的编辑结果如果不确认,30 分钟后过期——标出要删的,或选出要留的那一张,然后确认。
- 编辑模型没有在成人内容上训练过。应用自己就是这么说的:你可以试,但多半会失败。生成是无审查的;编辑不是同一个工具,也没有同样的承诺。
图像编辑需要 Premium。