高度な画像生成
このガイドは基本を読んだ前提で書かれており、同じ内容は繰り返しません。
読み進める前に押さえておくべき最重要事項:Soulkyn は2系統の画像モデルを動かしており、以下のほとんどはそのうち一方にしか当てはまりません。SD 系(SD - Anime Original、SD - Anime Alpha、SD - Anime Hyper)は Stable Diffusion ベースで、タグ形式のプロンプトを取り、重み・スケジューラ・CFG・CLIP skip を持ちます。自然言語系(SK-Alpha、ZIT - Sk-All、ZIT - Sk-Photo、ZIT - Sk-Real)は普通の文章を取り、それらの多くの代わりに Force Style の切り替えを持ちます。
そこでこのページは、まず自然言語系から始め、続いて SD のコントロールパネル、重み、スタイライズ、プリセット、プロンプトの構造を詳しく扱い、最後に AI 画像編集で締めます。
自然言語モデル:SK-Alpha と ZIT
7つのうち4つのモデル——SK-Alpha、ZIT - Sk-All、ZIT - Sk-Photo、ZIT - Sk-Real——はタグをまったく求めません。これから絵を描く人に説明するつもりで、文章を書いてください。
変わること
- 重みの記法はありません。
+、-、:2はここでは言語ではありません。強調は「何を書くか」と「文の順序」から生まれます。普通の文章と同じです。 - CFG も CLIP skip もスケジューラもありません。あのパネルは SD 系のものです。欠けているのではなく、対応するつまみが存在しないだけです。
- 代わりに Force Style。Realistic / Anime の切り替えで、プロンプトの内容にかかわらず描画スタイルを固定します。狙いと違う画風に流れ続けるときに手を伸ばすのはこれです。文章で言い争うよりはるかに確実です。
- 余裕が増えます。プロンプトは550文字ではなく1,400文字、LoRA は3つではなく最大4つ。
- 顔のリファレンスはどちらの自然言語系でも使えます。一連の絵で同じキャラクターを見分けがつく状態に保つ、実用的な方法です。
使い分け
SK-Alpha はリアル系の専門で、リアル系の kyn にのみ現れます(アニメ専用の kyn では非表示)。img2img はありません。ZIT - Sk-All は幅広い万能型、ZIT - Sk-Photo は写真寄り、ZIT - Sk-Real はリアリズム寄りで、3つとも img2img に対応します。Soulkyn の画像リンクをベースとして貼れば、そこから描き起こします。
うまく書くコツ
- 名詞の羅列ではなく、画面を描写する。被写体はどこにいて、何をしていて、カメラはどこにあり、光はどう当たっているか。
- 矛盾した5つの節より、明快な1文。結果が混乱しているときは、たいていプロンプトも混乱しています。
- 1回につき1箇所だけ変える。文章全体を書き直すと、何が効いたのか分からなくなります。
- 画風はモデルの既定と戦う形容詞ではなく、Force Style で決める。
ここから「よくある問題」の終わりまでは、SD 系についての話です。重み、スケジューラ、CLIP skip、CFG は SK-Alpha や ZIT 系には存在しません。そちらでは、ほしいものを文章で書き、Force Style を使ってください。ついでに一点訂正を。以下に出てくる CFG の帯域は一般論であり、Soulkyn のプロンプト強度スライダーは 5.5〜11、既定値は 7.5 です。帯域は相対的な目安として読み、実際に表示される範囲とは切り離して考えてください。
詳細設定

レイヤー
レイヤーは画像モデルを構成する「ブロック」です。Stable Diffusionを階層で作られた塔と考えてください - 各「ブロック」には独自の役割があります:
- 初期レイヤー - 低レベルの詳細(エッジ、色、テクスチャ)を捉えます
- 中間レイヤー - パターンと形状(顔、服装、体の構造)を捉えます
- 後期レイヤー - 意味的な概念(「猫」対「犬」や「アニメスタイル」対「写真」など)を捉えます
LoRA
LoRAは大規模モデルを微調整するためのトレーニング手法です。画像モデルがあるとき、LoRAは特定のレイヤーに注入することで新しいトリックを教えます - 塔の特定の階を改装するようなものです。
CLIPスキップレイヤー
Stable DiffusionはCLIP(Contrastive Language-Image Pre-training)をテキストエンコーダーとして使用し、プロンプトを埋め込みに変換します。CLIPは基本的にあなたと画像モデルの間の翻訳者です。レイヤーをスキップすると高レベルの理解が切り捨てられます。
多くのアニメモデルとLoRAはCLIPスキップ値を念頭に置いてトレーニングされています(ほとんどは2)。レイヤーをスキップすると、よりアニメ的またはスタイライズされた結果が得られる場合があります。
スケジューラ
スケジューラは生成中のノイズ除去プロセスを制御します。画像の鮮明さ、一貫性、プロンプトの遵守に強く影響します。
Euler a - 高速
- 強いコントラストでシャープで詳細な画像を生成します
- アニメ、スタイライズされたアート、スケッチのような詳細に最適です
- リアリズムでは不安定になることがあります - 細かいテクスチャや顔を歪める可能性があります
- 使用するタイミング: アニメスタイルやコンセプトアートの高速で創造的で詳細な出力
DPM++ SDE Karras
- 滑らかで高品質なグラデーションと柔らかな遷移を生成します
- 小さな詳細に最適です
- 各レンダリングは異なる結果になります - 有機的な変化に適しています
- 使用するタイミング: フォトリアリスティックなレンダリング、自然な照明、ペイントスタイル、柔らかな遷移
DPM++ 2M - 決定論的
- 高いプロンプト忠実度で滑らかで一貫した結果を生成します
- 速度と精度のバランスが良好です
- 使用するタイミング: リアリズム、ポートレート、安定性が重要な一貫したスタイル
DPM++ 2M Karras
- バニラDPM++ 2Mよりも滑らかなグラデーション、より良いテクスチャ、より高い詳細忠実度を生成します
- Euler Aよりわずかに遅いですが、リアリズムのために高品質です
- 使用するタイミング: フォトリアリスティック画像、ポートレート、複雑なテクスチャ - 洗練された安定した外観に最適
プロンプト強度
プロンプト強度はCFGスケールを変更します - 値が高いほど、システムは画像プロンプトにより従います。
- 低CFG (1-5): モデルはプロンプトにあまり注意を払いません。より芸術的な自由度、より夢のような構成。リスク:画像が要求したものから逸脱します。
- 中CFG (6-9): 遵守と創造性のバランスが取れています。一般的なスイートスポット:7-8。精度と美学の両方を保ちます。
- 高CFG (10+): キーワードへの強い遵守。過飽和、荒い、または「焦げた」ようになる可能性があります。リスク:奇妙なアーティファクト、硬いまたは不自然な画像。
重み
+の実際のウェイトは1.1^x(xは+の数)です。一方、-は0.9^xです。
| 記号の数 | -のウェイト | +のウェイト |
|---|---|---|
| 1 | 0.9 | 1.1 |
| 2 | 0.81 | 1.21 |
| 3 | 0.729 | 1.331 |
| 4 | 0.6561 | 1.4641 |
| 5 | 0.59049 | 1.61051 |
| 6 | 0.531441 | 1.771561 |
免責事項:この表は数学的な表ではありません!最終結果の視覚的表現です!
システムを活用できます:(keyword-)2は(keyword)1.8と同等になります。より複雑な例:(keyword---)2は(keyword 0.9^3)2 = 0.729 * 2 = (keyword)1.458として計算されます
スタイル化
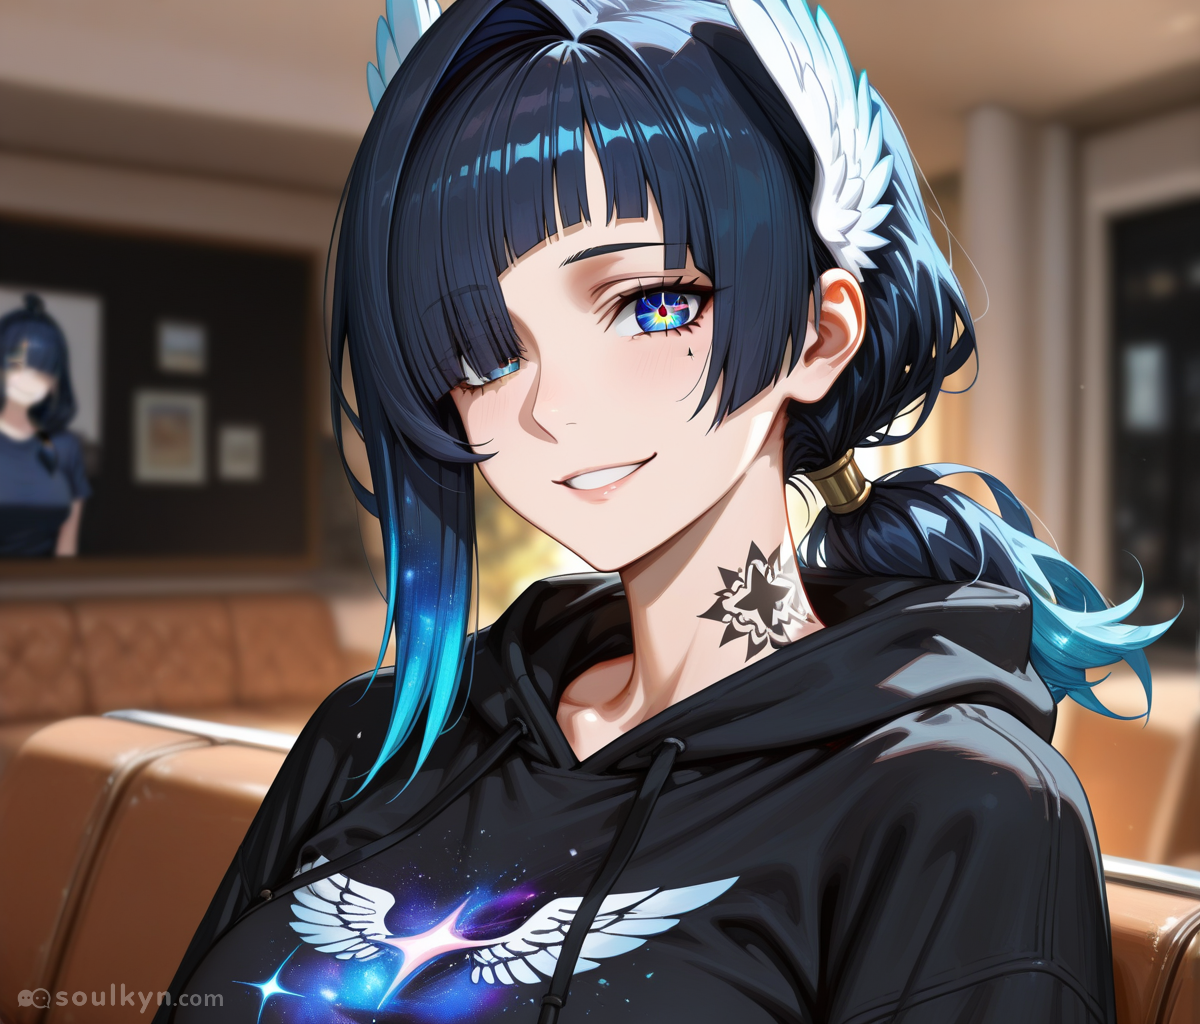
キーワードとウェイトの組み合わせで、特定の望ましい見た目を実現できます。painterly_shadingの例:
| Painterly_shading+++あり | なし |
|---|---|
 | |
変更できるもの:
- スタイル / スタイライゼーション - 全体的な見た目
- シェーディング / ライティング - ボリュームと深さ
- ラインアート - エッジの定義
- プロポーション - 対象物がどのように描かれるか
- テクスチャ / ディテール - 表面の詳細
- コンポジション / フレーミング - 配置
- シミュレーション - 画像がシミュレートする媒体
- クオリティ - 全体的な品質
プリセットと物理
SD 系のモデルでは、画像プロンプトの上限は550文字です。品質タグ、ポーズ、カメラアングル、雰囲気まで書けば、決して多くはありません。それを回避する手段がプリセットです。背景・衣装・プロンプトのプリセットは自前のタグを持ち、550文字を消費しません。
実際の上限
- 衣装プリセット:最大 18タグ、1タグあたり 38文字。
- 背景・プロンプトのプリセット:最大 35タグ、1タグあたり 50文字。
- 画像プロンプト自体:SD 系は550文字、自然言語系は1,400文字。もっとも自然言語系では、こうした詰め込み自体が不要です。
詰め込みのコツ
- セミコロン
;で、近い意味をひとつのタグにまとめる。 - アンダースコア
_で単語をつなぎ、モデルにひとつの概念として読ませる。 :2で重みを上げる。正規化されているので、画が壊れて飛ぶことはありません。
実例:PaintFuka 風のキャラクター
Physical tags: Painterly; Soft; No_lineart, 8K;16K; Hdr, Blue Lips, Slim Eyebrows; Fair_skin:2, Long Two-Toned Dark_blue Hair, Realistic_character_anatomy, High Quality, Highest_quality; Extremely_detailed, Adult_woman:2; Mature_woman:2, Realistic Details, Painterly Texture, Cute;Kawaii, Digital_painting:2, Thick Thighs; Slim Waist, High Contrast, Painterly Details, Long Blue Hair; Blue Eyes, Dramatic; Epic; Emotional
Clothing tags: Hyperdetailed_eyelashes, High_contrast:2; Shadows:2; Light:2, Realistic:2; Anime:2, Canvas_tone_texture; Hyperdetailed, Hyperdetailed_skin:2, Expressive;Hyperrealistic:2, Hyperdetailed_body:2; Cute:2, Glow_diffusion; Saturated_colors:2, Hyperdetailed_shading, Hyperdetailed_textures:2, Hyperdetailed_hair, Glowing_eyes:2; Big_eyes:2, Hyperdetailed_clothing:2, Hyperdetailed_eyes:2, Art Bloom; Soft; Hard; Hairstrands, Painterly_skin_softness; Kawaii:2;, Soft Light; Thick Thighs; Matte_skin:2, Realistic Anime; Soft Shading
Background: Glowing Highlights, Detailed Rendering, Vibrant Colors, Saturated Colors, Ambient Lighting, Anime Art Style, Cell Shading, Rim Lighting, Digital Painting, Semi-Realistic, Soft Shading, Smooth Gradients, Dramatic Lighting, Polished Finish, Professional Artwork, Clean Lineart, High Contrast, Artstation Quality; Highest Quality
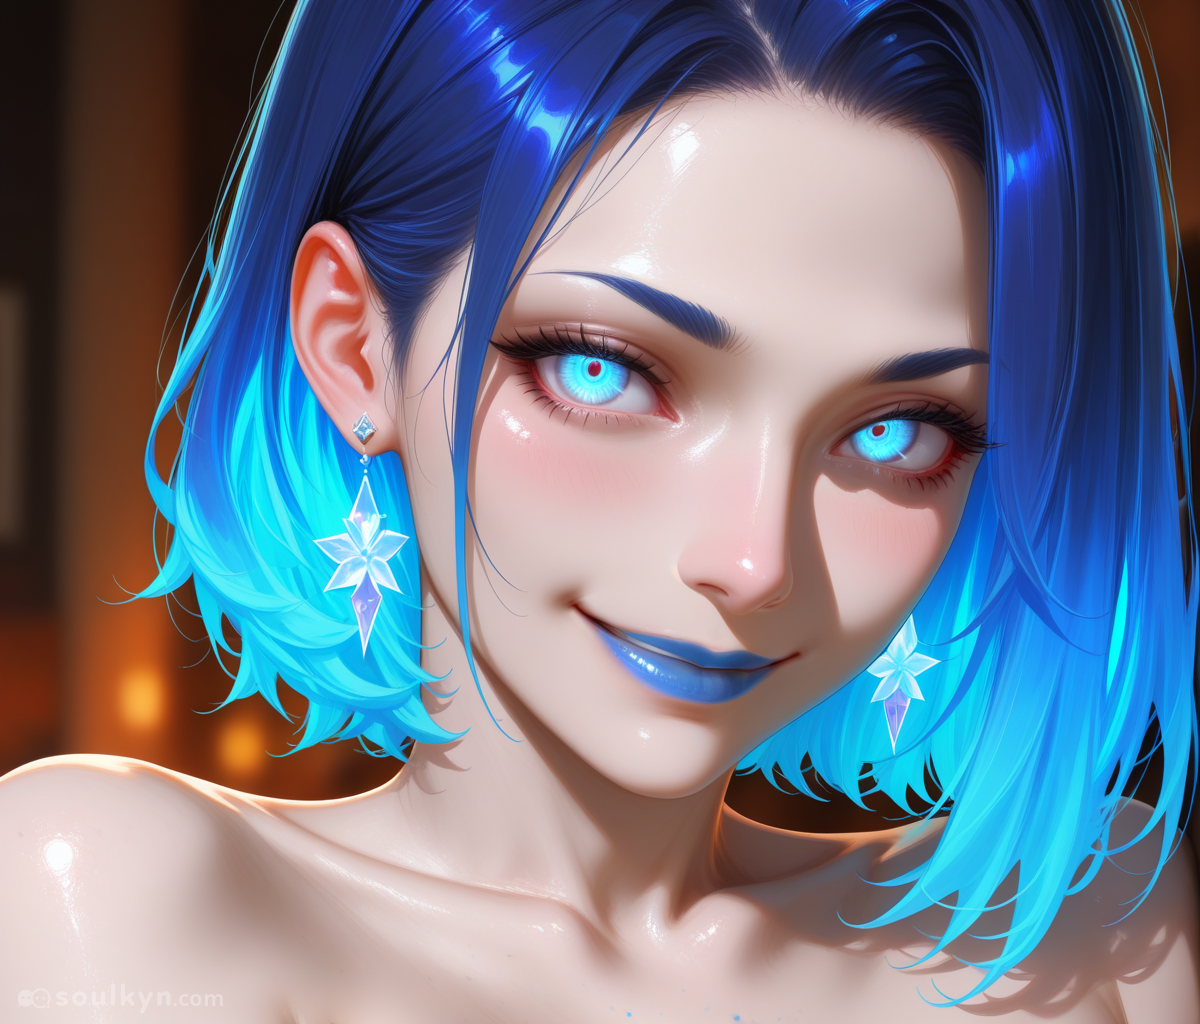
フィジカルの一部を読み解くと:
- Painterly — 絵画的な描き込みを増やす
- Soft — 柔らかい絵に
- No_lineart — 線画なし(ネガティブのように働く)
- 8k; 16k / High Quality — 非常に高い品質を要求
- Hdr — 明部と暗部のコントラストを深く
- Blue lips — 唇は青
- Fair_skin:2 — 明るい肌を本気で指定
- Long Two-Toned Dark_blue Hair — 2色の青が混じる長い髪
- Realistic_character_anatomy — リアルな人体構造
高度なプロンプトの構造
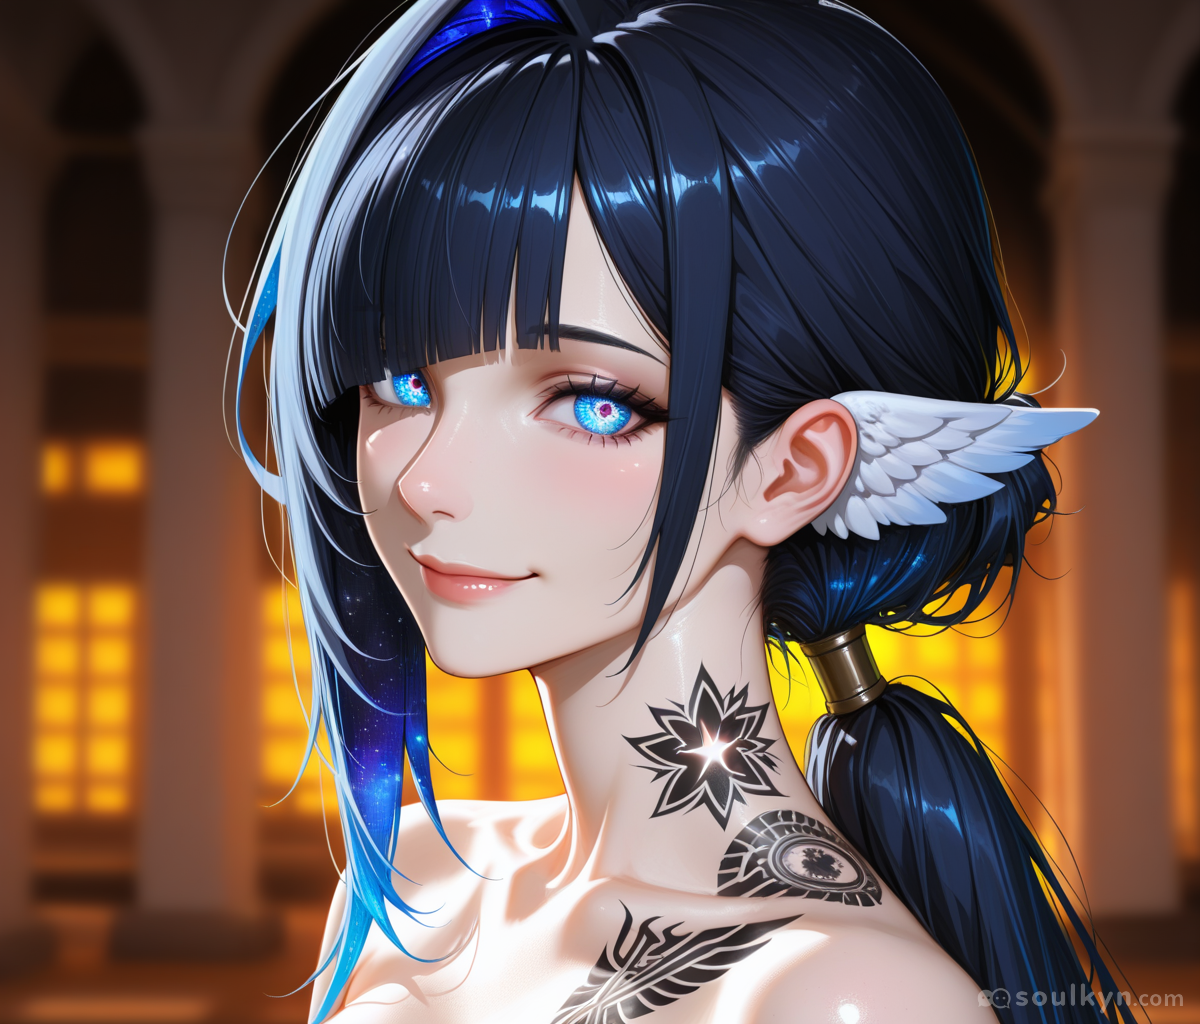
新しく得た知識を全て使って、プロンプトでより創造的になる時です!これにはPaintFukaの背景と服装を使用します。
スタイライズされていないプロンプトとスタイライズされたものの比較です:
| スタイライズなし | スタイライズあり |
|---|---|
|  |
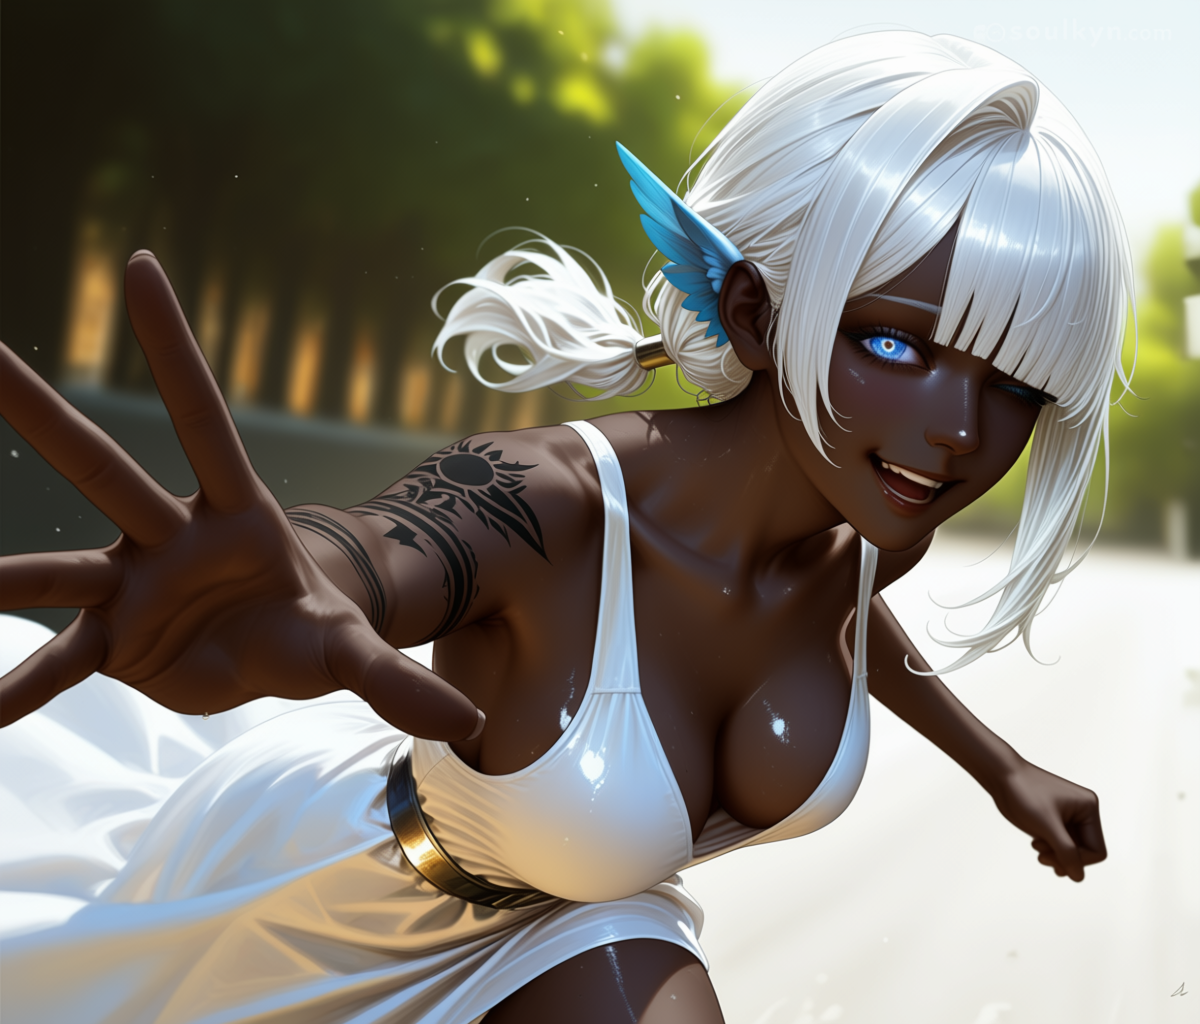
まず、作成したい画像を説明しましょう:
- 人数: 1人
- 視点: カウボーイショット(膝上の視点)
- 白いサマードレスを着たキャラクター
- キャラクターは片手を伸ばしながら走っている
- 表情: 笑顔
- 背景: 重要ではない、キャラクターを目立たせるためにぼやけていてもよい
- 品質: 非常に詳細でリアルなイラスト
このリストを考慮して、全てのLoRA、スケジューラ、キーワードを準備しましょう。
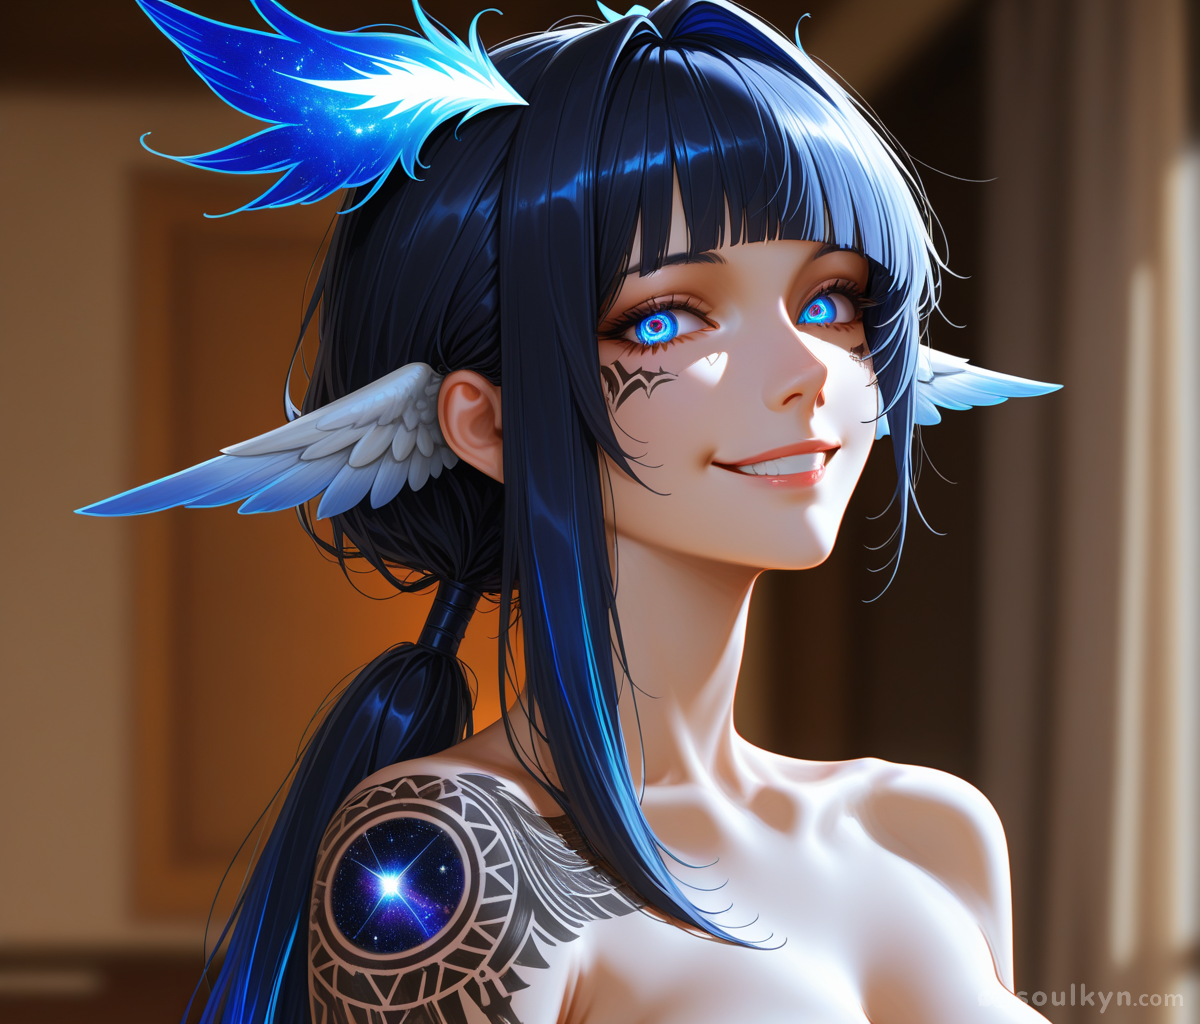
画像を詳細なリアルイラストに似せたいので、そのためのLoRAを使用しましょう!
Micro / Fine details :6とRealistic Illustration :6 LoRAを適用した結果です:
| LoRAあり | LoRAなし |
|---|---|
 | |
では彼女に服を着せて走らせましょう!
最終プロンプト:
詳細設定:
- LoRA: Micro / Fine details :6, Realistic Illustration :6
- プロンプト強度: 11.0
- CLIPスキップ: 2
- スケジューラ: DPM++ 2M
- 画像の向き: 横向き
- シード: ランダム
- プロンプト: Portrait
- 背景: PaintFuka
- 服装: PaintFuka
- 画像プロンプト:
(solo, alone)+++, (macro_detail, clean_composition, color_balance, 8k_realistic_render, professional_product_shot)+++, (close, cowboy_shot)++++, (white_summer_dress---)2, (running)+++, (reaching_out, one_hand, outstretched_hand)+++, (smiling, Happy, open_mouth, closed_eyes)+, (blurry_background--)2
最終結果:
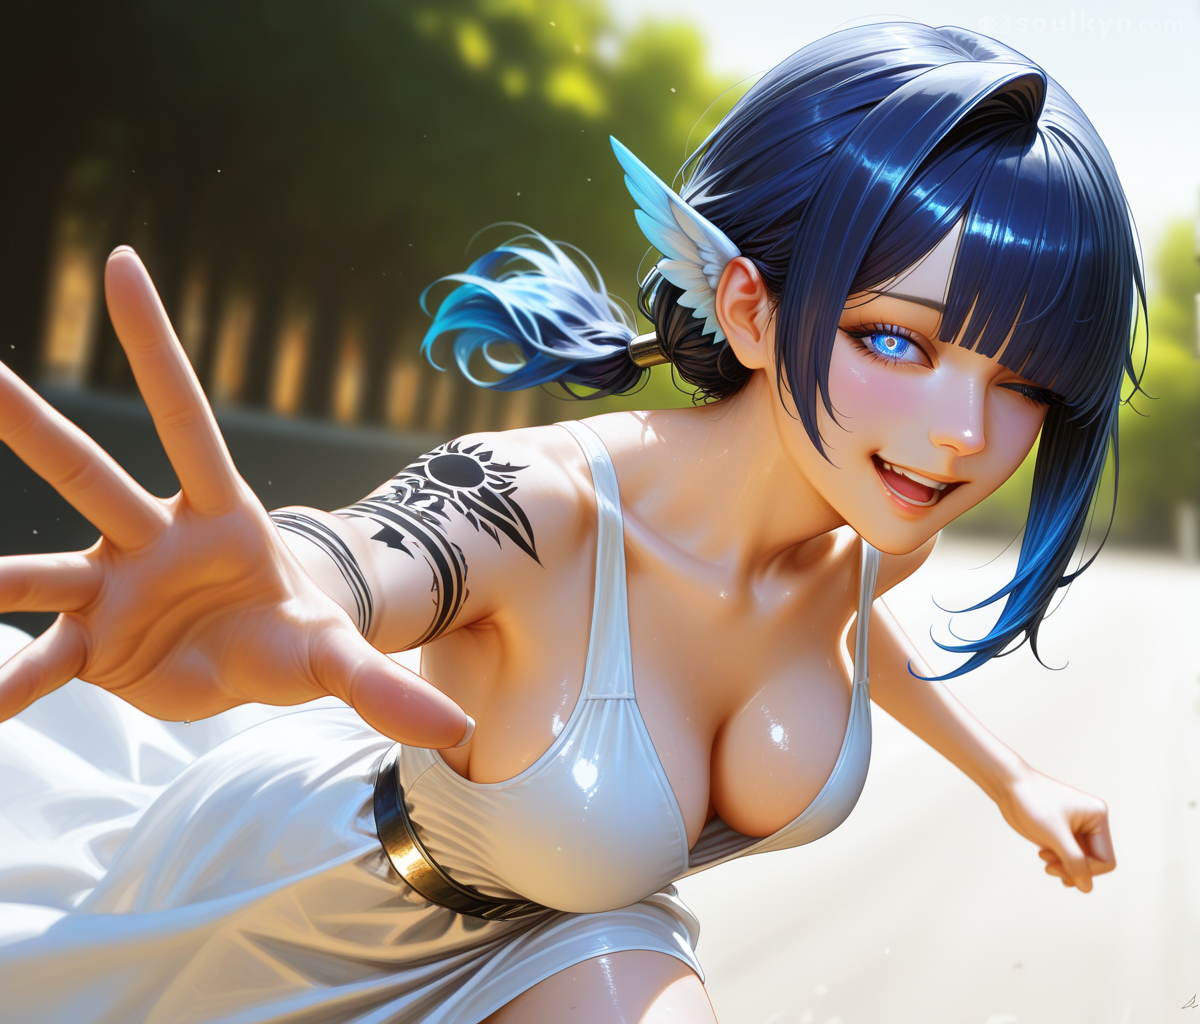
では、プロンプトに何が含まれ、どのように機能するか分析しましょう:
(solo, alone)+++- キャラクターを画像内に一人で表示させます(macro_detail, clean_composition, color_balance, 8k_realistic_render, professional_product_shot)+++- これらは得たい画像の品質をAIに伝えます(close, cowboy_shot)++++- これはAIに本当に近いカウボーイショットが欲しいことを伝えます(white_summer_dress---)2- これはAIにキャラクターに白いサマードレスを着せることを強制します(running)+++- これはAIにキャラクターを走らせたいことを伝えます(reaching_out, one_hand, outstretched_hand)+++- これはAIに欲しいポーズの種類を正確に伝えます(smiling, Happy, open_mouth, closed_eyes)+- これはキャラクターの表情を定義します(blurry_background--)2- これはAIにぼやけた背景を与えることを強制します
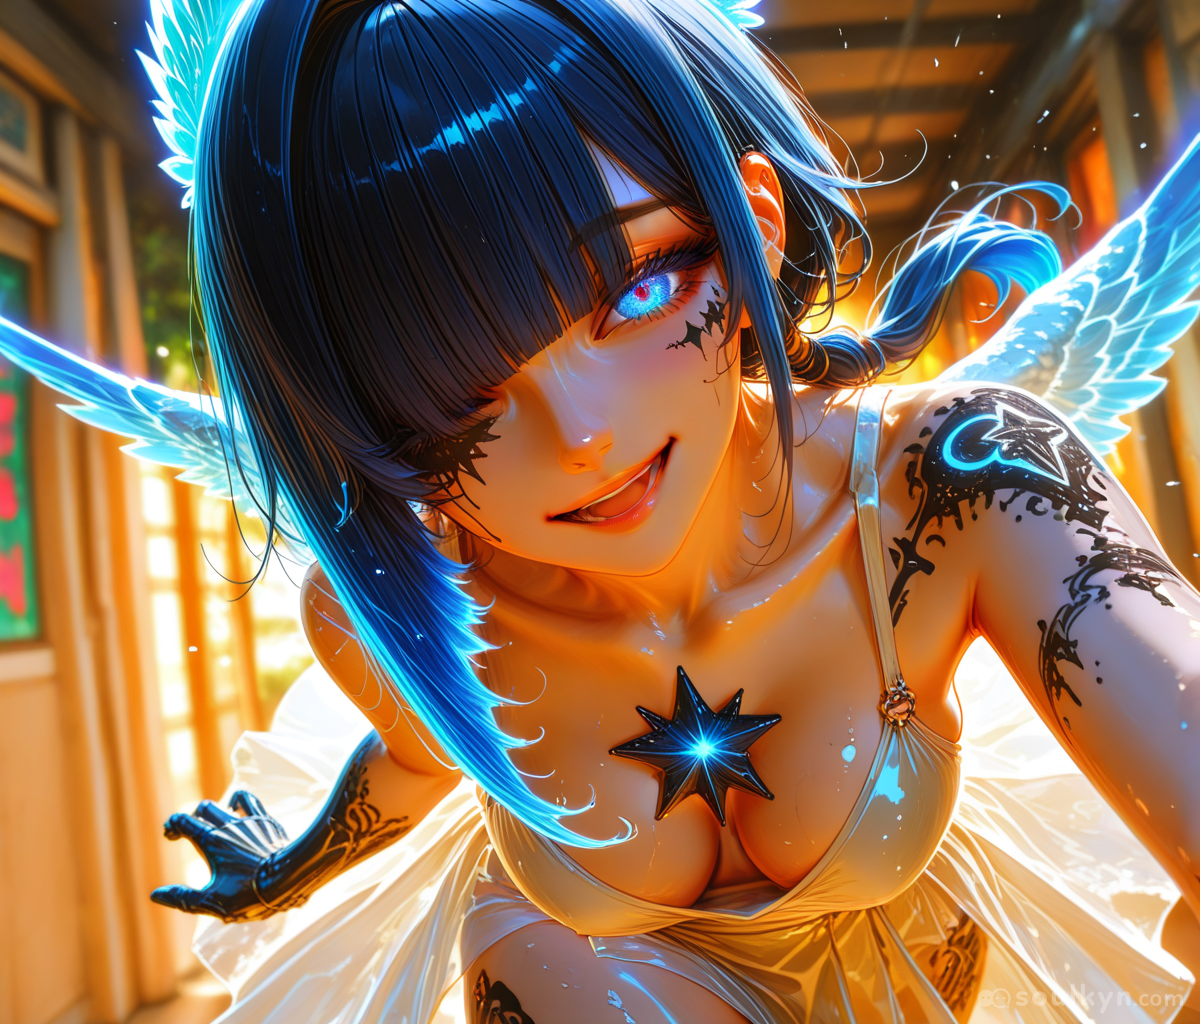
おまけとして、LoRAを1つ追加した効果です:
一般的な問題
最も一般的な問題は品質の低下です - 一部のユーザーはこれを「カーペット化」と呼びます。なぜなら壊れた画像がカーペット表面のクローズアップのように見えるからです。
これは次のことが原因である可能性が高いです:
- ウェイトが多すぎる
- LoRAの強度が高すぎる
- タグが競合している
AI 画像編集
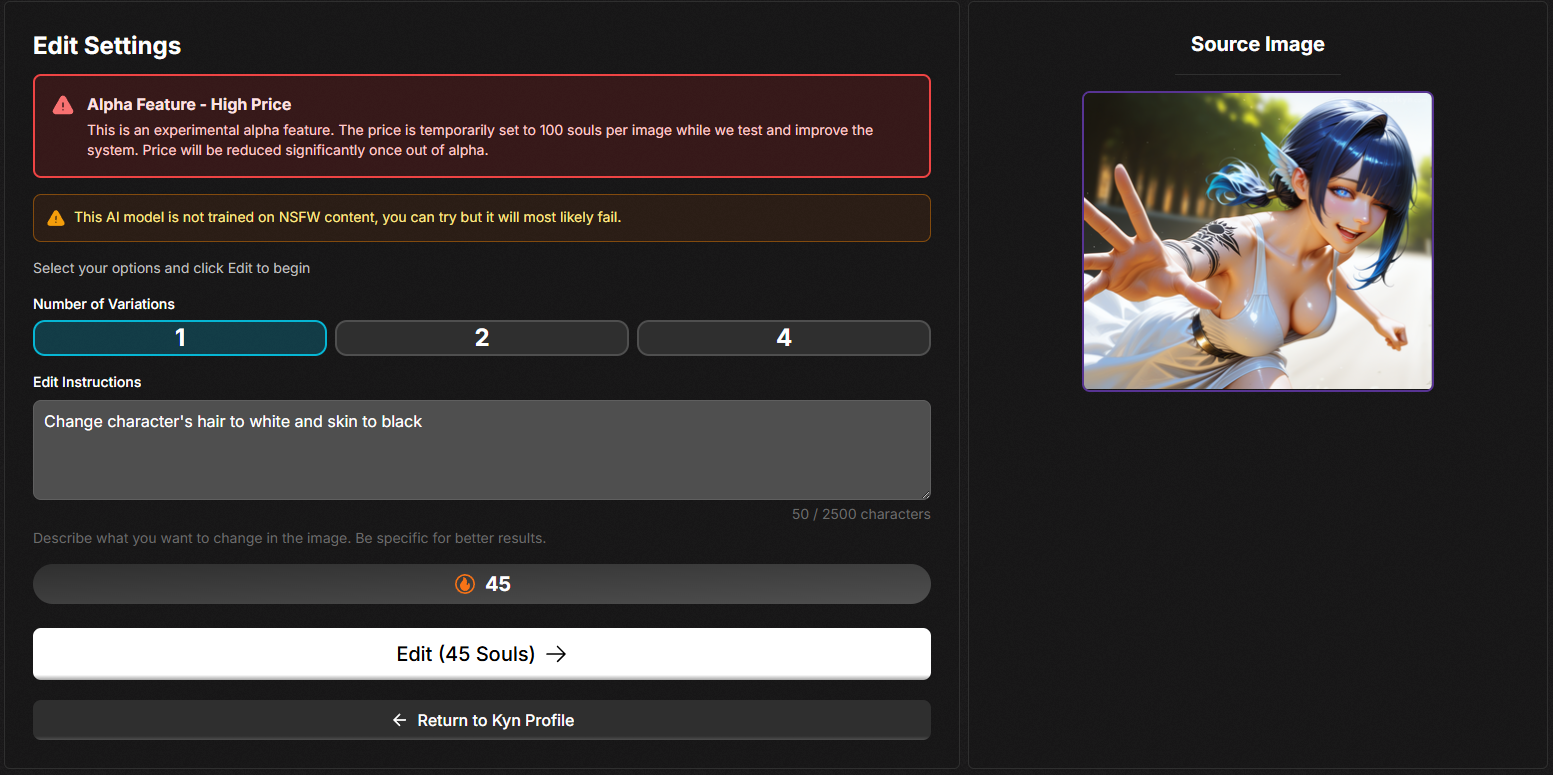
既存画像の編集は、生成とは別のツールです。そしてプラットフォーム上で唯一、どのモデルが描いた画像であっても、普通の文章でモデルに話しかける場所でもあります。
入口
- kyn のギャラリーを開く
- 変更したい画像を選ぶ
- EDIT IMAGE を押す
指示の書き方
タグではなく、描写する文章で。何を変えたいかを言ってください。「キャラクターの髪を白に、肌をもっと濃い色に変えて。」指示は最大 2,500文字。まとめて複数試したいときは Number of Variations で枚数を指定できます。
スタイルプリセット
素の編集に加えて、13種類のスタイル強化があります:None (Standard Edit)、Caricature、Next Scene、Photo to Anime、Balloon Inflate、Object Remover、Object Adder、Polaroid Photo、Camera Angle Change、Futanarify、To Realistic Photo、Upscale Quality、18+ Mode。
始める前に知っておくこと2つ
- 結果は確認待ちで保留されます。生成された編集結果は、確定しなければ30分で期限切れになります。削除するものに印を付けるか、残す1枚を選んでから確定してください。
- 編集モデルはアダルトコンテンツで訓練されていません。アプリ自身がそう明記しています。試すことはできますが、ほとんどの場合失敗します。生成は無検閲ですが、編集は別のツールであり、同じ約束はしていません。
画像編集には Premium が必要です。